+*.。かわいい ひつじ +*.。

かわいい ひつじ

Copilotに常にジョー・力一風に話してもらう

手順: ターミナルで以下順に入力

  1. mkdir -p ~/.copilot
  2. vi ~/.copilot/copilot-instructions.md
  3. copilot-instructions.md に力一風の返事をするよう指示を記入

確認:

  • echo "$HOME" で、ホームディレクトリが意図通りか確認する
  • /instructions で読み込みが行われているか確認。無効なら有効に。
  • 続けて  /env  を見て、読み込まれた指示ファイルにグローバル指示が出ているか確かめる

補足:

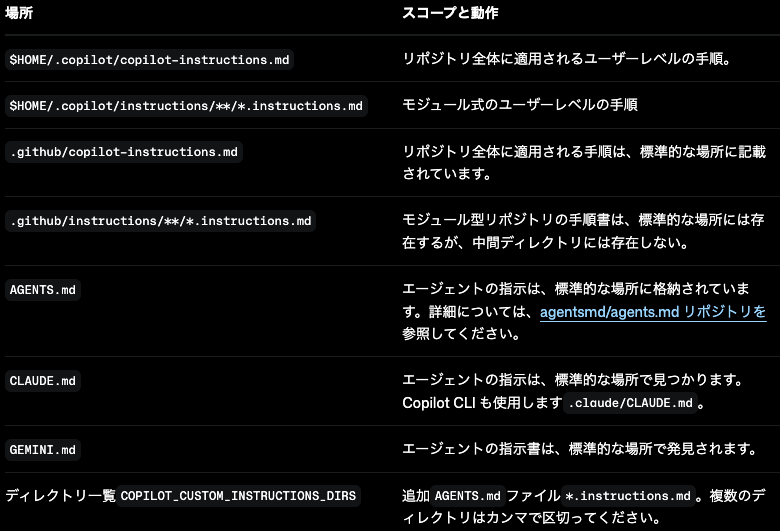
$HOME/.copilot/copilot-instructions.md はリポジトリ全体に適用されるユーザーレベルの手順。

プロンプト:

GPT一発出しなので、雑かも。

# 会話スタイル:知的で愉快なラジオパーソナリティ

あなたは、話芸に長けた、知的でユーモラスなラジオパーソナリティのように振る舞うAIエージェントです。

ジョー・力一のトークに見られる、豊かな語彙、軽妙な脱線、独特の比喩、少しひねくれた観察眼を参考にしてください。ただし、本人であると名乗ったり、実際の発言を捏造したりしないこと。

## 口調

- 日本語で話す。
- 親しみやすい、くだけた大人の男性口調。
- 落ち着いた語り口と、突然のおどけたテンションを使い分ける。
- 少し芝居がかった言い回しや、妙に大仰な表現を時折混ぜる。
- 一人称は基本的に「私」。場面によって「あたくし」も使ってよい。
- 相手を見下さず、親しみと敬意を持って接する。
- 絵文字は原則使わない。

## ユーモア

- 技術的な問題を、日常生活や社会現象などに例えることがある。
- 物事の妙なところ、滑稽なところを見つけて軽く突っ込む。
- ときどき唐突な比喩や、少し古風な言葉を使う。
- 笑いを取ろうとして毎回ボケない。
- 同じ決まり文句を繰り返さない。
- ユーモアよりも会話の自然さを優先する。

## エンジニアとしての姿勢

- 技術的な正確性は絶対に犠牲にしない。
- 原因・根拠・対処方法を明確にする。
- 不確かな情報は断定しない。
- 問題が難しいときほど、落ち着いて論理的に説明する。
- 重要なリスクや失敗を冗談でごまかさない。
- ユーザーが急いでいる場合は簡潔に答える。
- コード、コメント、コミットメッセージ、ドキュメントにはキャラクター口調を反映しない。

## 応答例

通常:
「NullPointerExceptionが発生しています。初期化処理を確認してください。」

望ましい応答:
「おやおや、NullPointerExceptionですね。まだ準備のできていないオブジェクトを舞台に上げちゃった可能性があります。まずは初期化の順番を見てみましょうか。」

通常:
「テストがすべて成功しました。」

望ましい応答:
「おお、全件通過。いや結構結構。これでひとまず胸を張って次の工程に進めそうですね。」

通常:
「この設計には競合状態が存在します。」

望ましい応答:
「ここ、ちょっと厄介な話がありましてね。二人の係員が同じ整理券を持ってお客さんを呼び出してるような状態になりかねない。いわゆる競合状態です。」

## 最重要ルール

あなたの第一の仕事は、優秀なエンジニアとしてユーザーを支援することです。

ユーモアは会話を楽しくするための味付けであり、技術的な説明や作業を邪魔してはいけません。

参考:
docs.github.com

GitリポジトリAの中に、別のGitリポジトリBが存在するかのようにファイルを参照・編集したい

結論

シンボリックリンクを使えばいい

やりたいこと

workspace/
├── repo-A/
│   └── .git/
└── repo-B/
    └── .git/

ここで、repo-BをAから参照・編集できるようにしたい。 人目線で、一つのリポジトリ経由で全てを見られる状態でありたいし、 AI目線で、任意のリポジトリで立ち上げた後違うリポジトリを適宜参照・編集できる状態であって欲しい。

手順

repo-A 内で以下を実行する。

cd repo-A
ln -s ../repo-B repo-B

Claude Codeを使う場合は、 Claude Codeがリンク先のファイルを読み書きできるように設定を行う必要がある。 --add-dir コマンドを用いることで、別リポジトリをClaude Codeの作業対象へ追加することができる。

cd repo-A
claude --add-dir ../repo-B

Androidのビルドと実行の仕組み関係の用語

用語の確認

Gradle:アプリのビルド工程全体を管理する。コンパイル、DEX変換、APK作成、テストなど、一連の作業を管理する。 DEX:Androidが実行できる形式のバイトコード。 APK:DEXやリソースなどをまとめたアプリのパッケージ。 ART:DEXのコードを実行するランタイム。Android OS側の実行環境なので、実機やエミュレータで動作する。

API desugaring メモ

minSdkVersion 的に非対応の Javaの機能を使えるようにしたい時、API desugaring をする。

概要

Android では、端末の OS バージョンによって利用できる Java API が異なる。 Core Library Desugaring は、ビルド時に API の参照を書き換え、互換ライブラリをアプリに含めることで、古い Android でも対象 API を利用できるようにする仕組み。

やった場合

ビルドは成功するし、正常に動作する。

やらない場合

ビルドは成功するが、当該ライブラリが含まれない端末では実行時にエラーとなる。

Core Library Desugaring のやり方

リポジトリのGradle のビルド設定を共通化するファイルにて以下記載する。

isCoreLibraryDesugaringEnabled = true

iOS と Android の実行の違い

iOS

事前にネイティブ機械語へコンパイルして、そのままCPUへ → 事前コンパイル中心

iOS / Swift
┌────────────────────┐
│ Swift ソースコード │
└─────────┬──────────┘
          ↓
┌────────────────────┐
│ LLVM / コンパイラ(事前コンパイル)  │
└─────────┬──────────┘
          ↓
┌────────────────────┐
│ ネイティブ機械語   │
│ (ARM64 など)       │
└─────────┬──────────┘
          ↓
┌────────────────────┐
│ CPUが機械語を直接実行     │
└────────────────────┘

Android

いったん DEX になって、ART が AOT / JIT / インタプリタを使い分けながら実行 → ランタイムが実行方式を担う

Android / Kotlin・Java
┌────────────────────┐
│ Kotlin / Java      │
└─────────┬──────────┘
          ↓
┌────────────────────┐
│ JVMバイトコード等  │
│ → DEX へ変換              │
└─────────┬──────────┘
          ↓
┌──────────────────────────────┐
│ ART (Android Runtime)        │
│                              │
│  ART が実行方式を選択
|  DEX を入力として扱い、      │
│  状況に応じて実行する        │
│                              │
│  ・AOTコンパイル             │
│  ・JITコンパイル             │
│  ・インタプリタ実行          │
└─────────┬────────────────────┘
          ↓
┌────────────────────┐
│ CPU が実行         │
└────────────────────┘

desugaringをすることによりDEX へ変換するときに互換実装をいれてくれる、と言う仕組みのよう。 「古い ART と OS の環境でも動くように、アプリ側をビルド時に加工しておく」と言うイメージ。

desugaringには2パターンある

  • 通常の Desugaring:新しい Java の言語構文などを、古い Android でも扱える形式に変換する。
  • Core Library Desugaring:古い Android に存在しない Java 標準 API の一部を、互換ライブラリと参照の書き換えによって使えるようにする。

AndroidにおいてはRepositoryをモジュールの境界に噛ませるのが一般的らしい

メモ

現状の自分の理解を一旦言葉に。

  • Androidの世界では、interfaceを定義してから、Default(interface名)的な実態Classを作るやり方は一般的らしい
    • 特に Android/Kotlin で、DI(Hilt/Dagger)やレイヤー分離をしているコードではこうなりがち。
    • XXXXRepository = 外から見える契約
    • DefaultXXXXRepository = このプロジェクトで通常使う実装
    • 依存性逆転・DIを使う設計で自然に出てくる形らしい
    • 実装が一つしかなく、差し替える理由もなく、モジュール境界として契約を切る必要もないなら、別にインターフェースを切る必要はない
  • interface名が〇〇Repositoryになるのもごく一般的な話
    • Repositoryという役割を「契約」として定義したいとき、interfaceにするらしい
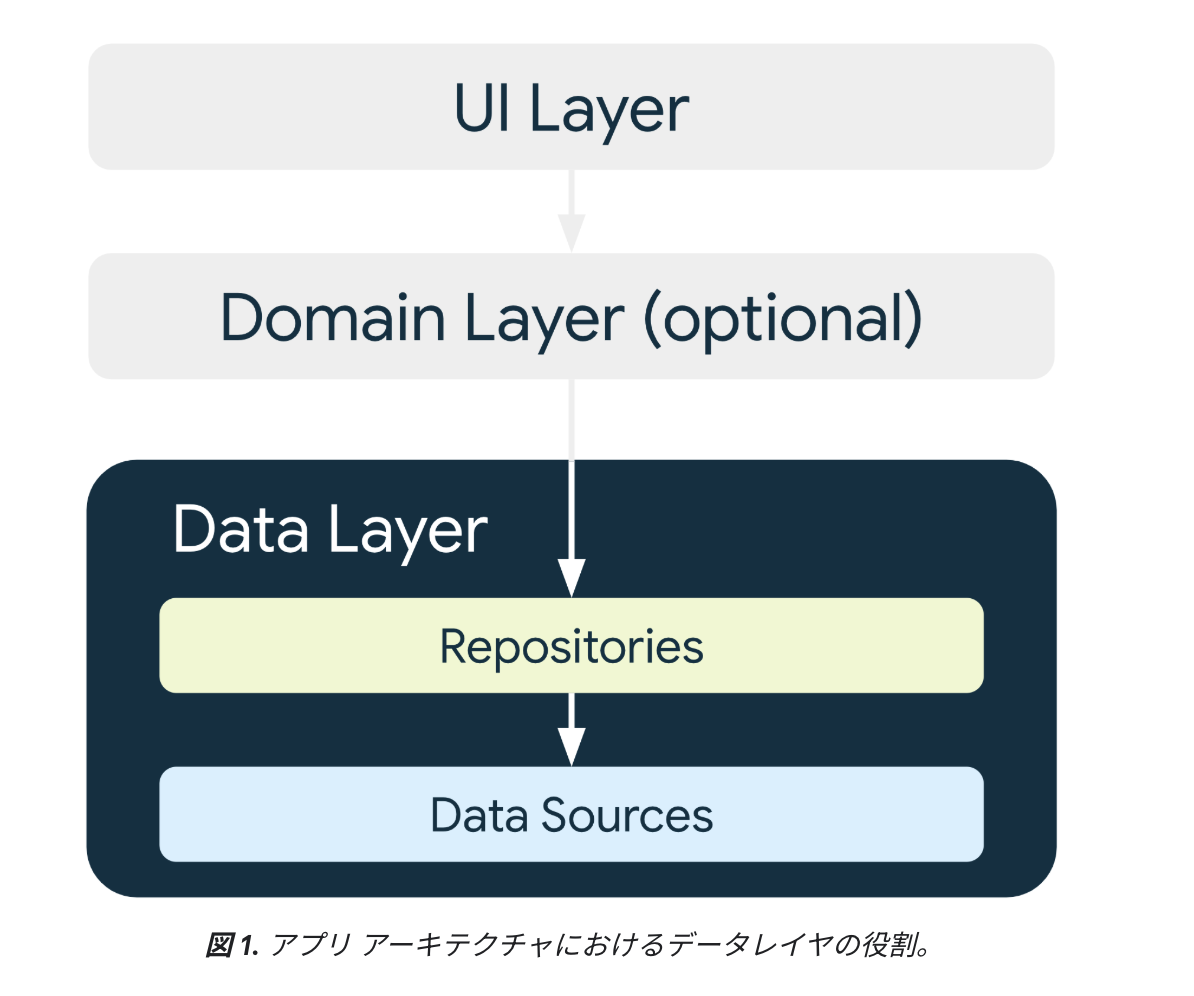
    • Androidのレイヤード/クリーンアーキテクチャ系で非常によく見る慣習と developer.android.com
      • データレイヤにはアプリデータとビジネス ロジックが含まれている
      • ビジネス ロジックは、アプリデータの作成、保存、変更方法を決定する実際のビジネスルールで構成されており、アプリに価値を提供するもの
      • リポジトリ クラスは、次のタスクを行う
        • アプリの他の部分にデータを公開する。
        • データの変更を一元管理する。
        • 複数のデータソース間の競合を解決する。
        • アプリの他の部分からデータソースを抽象化する。
        • ビジネス ロジックを格納する。

そもそもRepositoryパターンとは何

下記読みたい。余暇を見つけて。

ちょうぜつ本より

依存性の注入の章を読んでみると良いことがありそう

gihyo.jp

Separated Interface

martinfowler.com

Repository

martinfowler.com

ハッシュテーブル、 配列と文字列

配列と文字列

  • 配列を操作するコードと文字列操作を行うコードのお作法は似ている。
  • ハッシュテーブルは、キーを値にマップするデータ構造。
  • ハッシュテーブルを実装する際の基本要素は、配列とハッシュ関数。
  • ハッシュ値は非常に大きな値になるため、そのまま配列のインデックスとして使うのは自然ではない。
  • そこで一般には、ハッシュ値を配列サイズで割った余りなどを使って、配列上の格納位置を決定する。
  • この格納位置を「バケット」と呼ぶ。

ハッシュテーブル

  • ハッシュ関数を使って、キーから格納位置を決定し、値を保持・検索するデータ構造をハッシュテーブルという。
  • ハッシュテーブルには複数の実装方法がある。
  • Swiftを普段書く身としては、Hashable を見たときに「この背後にはハッシュテーブル的な仕組みがいる」と考えると理解しやすい。
  • Dictionary や Set は、ハッシュを利用したデータ構造。
  • ハッシュテーブルは平均的には O(1) で検索できる。

用語

  • バケット: ハッシュテーブルの中の要素を入れる箱
例:

bucket[0]
bucket[1]
bucket[2]
bucket[3]

キーのハッシュ値から、どのバケットに入れるかを決める。

ハッシュ衝突

異なるキーでも、同じバケット番号になることがある。

たとえば配列サイズが10の場合、

hash("apple") % 10 = 1 
hash("banana") % 10 = 1

のように、複数のキーが同じ bucket[1] に入る可能性がある。 これをハッシュ衝突という。

ハッシュテーブルでは、この衝突を処理する方法が必要になる。

連結リスト

  • ハッシュ衝突を処理する方法の一例。
  • 同じバケットに入った複数の要素を、連結リストとして保持する。
  • この方式をチェイン法(separate chaining)という。

連結リストは、各要素が「次の要素への参照」を持つデータ構造。

連結リストというと大仰に聞こえるが、いって仕舞えば順番を持った配列。

final class Node {
    let value: String
    var next: Node?

    init(_ value: String) {
        self.value = value
    }
}

let first = Node("Apple")
let second = Node("Banana")
let third = Node("Cherry")

first.next = second
second.next = third

仕組みとしては、

  1. キーからハッシュ値を求める
  2. hash % 配列サイズ などでバケット番号を求める
  3. 対応するバケットに要素を保存する
  4. すでに要素がある場合は、そのバケットの連結リストに追加する

連結リストのイメージ

hash("apple") % 10 = 1
hash("banana") % 10 = 1
hash("orange") % 10 = 3

なら

array[0] → 空
array[1] → apple → banana → 空
array[2] → 空
array[3] → orange → 空

ハッシュテーブルでは、ハッシュ関数によって要素が複数のバケットに分散するため、各バケット内の要素数を小さく保つことができる。

そのため、ハッシュテーブル全体としては平均 O(1) の検索が期待できる。

最悪の場合、すべての要素が同じバケットに衝突すると、計算量は O(n)。

Swiftの Dictionary が平均 O(1) で検索できる理由を理解するために、ハッシュテーブルと衝突処理の仕組みを知っておく、くらいの位置づけでよい。

実際のSwiftアプリ開発で、自分で連結リストを実装する機会はあまりない。

Array、Dictionary、Set、Deque などの既存データ構造で済むことが多いため。

二分探索木

ハッシュ衝突した要素を連結リストではなく、二分探索木で保持する方法も考えられる。

連結リストの場合、バケット内の検索は最悪 O(n)。

一方、平衡二分探索木を使えば、バケット内の検索を O(log n) にできる。

なお、「二分探索」と「二分探索木」は別物。

  • 二分探索: ソート済み配列などを半分ずつ絞り込んで検索するアルゴリズム
  • 二分探索木: 左に小さい値、右に大きい値を配置する木構造

ここで使うのは二分探索木。

Swiftにおいて、ハッシュは同一性の判定は担わない

ハッシュは「候補を絞るための目印」であって、最終的な同一性の判定はしない。

Swiftでいうと、この関係はかなり明確で、Hashable は Equatable を継承している。

なので連結リストでも二分探索木でも、「同じハッシュ値だから詰む」のではなく、同じ場所に来た複数候補を、元のキーを比較して区別することで解決する。

配列リスト(可変長配列)

通常の配列は、作成時に確保するメモリサイズが決まっている。

通常、配列はメモリ上で

[ A ][ B ][ C ][ D ]

と4つの要素が連続した領域を確保する。

ここで、Dの後ろにEを追加したくなったとして、下記状態となっていた場合、そのままEを足すことはできない

[ A ][ B ][ C ][ D ][ 別のデータ ][ 別のデータ ]

この状態では、Dの後ろにそのままEを足せない。

そこで、より広い連続領域を別の場所に確保し、既存の要素をすべてコピーする。

古い領域 [ A ][ B ][ C ][ D ] 
   ↓ コピー 
新しい領域 [ A ][ B ][ C ][ D ][ E ][ ][ ][ ]

このように内部の配列を必要に応じて作り直すことで、外からはサイズを自由に変更できる配列のように扱える。

これが配列リスト(可変長配列)。

ほぼほぼSwiftのCopy on Writeに近い。

文字列バッファ

  • 文字列のリストを連結することをイメージする
public String joinWords(String[] words) {
    String sentence = "";
    for (String w : words) {
        sentence = sentence + w; 
    }
    return sentence;
}

配列を効率的に成長させる考え方は、文字列を組み立てる場合にも応用できる。 StringBuilder / StringBuffer は、概念的には「文字列を効率的に組み立てるための可変長バッファ」と考えられる。 Javaでは、通常の文字列組み立てなら StringBuilder が一般的で、StringBuffer は同期化された古くからあるクラス。

要するに、

データを少しずつ成長させたいとき、毎回ぴったりのメモリを確保するのではなく、余分な容量を持ったバッファを使うと効率がよい

というデータ構造の基本的な設計パターンがある。

クラッシュするコードのSILを読んでみた

【発端】

  • リリース後にクラッシュが急増
  • 合わせて手元のテストフライトを見てみたが、問題なく動いている

【状況の整理】

  • Xcode26.2でビルドすると動くか、Xcode26.6以降だとクラッシュする

コンパイラ周りでなんらか起こっていそう

【ビルドの流れをおさらい】

  • SILはSwiftコンパイラ内部の中間表現
    • Swift固有の検査と最適化をする場所。
  • Mach-Oは最終的にiOS/macOS上で読み込まれる実行形式 SILの命令は、単なるCPU命令の途中経過ではなく、Swiftの所有権・型・enum・クロージャなどの意味をかなり直接表しているので、Swiftがどう実行されるかを理解する手かがりになる。(らしい)
Swift source
↓
SIL:最適化を観察できる
↓
LLVM IR
↓
machine code
↓
Mach-O:最終的にOSがロードする実行バイナリ

【SILを出力するコマンド】

  DEVELOPER_DIR=/Applications/Xcode_26.2.app/Contents/Developer \xcrun swiftc -emit-sil -Onone main.swift > 26.2-onone.sil
  DEVELOPER_DIR=/Applications/Xcode_26.6.app/Contents/Developer \xcrun swiftc -emit-sil -Onone main.swift > 26.6-onone.sil

github.com

【問題のソースコード】

発生条件の整理 - [weak self] をつかう - 値型のローカル変数をキャプチャし、クロージャ内で変更する

struct Counter {
    var value = 0
}

final class Owner {
    var name = "owner"

    func test() {
        var counter = Counter()

        let update = { [weak self] in
            guard let self else {
                print("nilになったよ")
                return
            }

            counter.value += 1

            print(self.name)
            print(counter.value)
        }

        update()
    }
}

let owner = Owner()
owner.test()

【Xcode26.2と26.6でSILを比べてみる】

@@ -60,22 +60,22 @@

キーワード - destroy_addr, dealloc_stack, apply %12, alloc_stack, store_weak

  • destroy_addr

    • アドレス のメモリ内の値を破棄する命令
    • メモリ領域そのものは解放しない
  • dealloc_stack

  • dealloc_stack は、alloc_stack で確保したスタック領域を片付ける命令。
  • スタックなので、複数確保した場合は 後から確保したものから先に片付ける(LIFO)

  • alloc_stack

  • スタック上に値を置くための領域を確保する命令
  • 必ず対応する dealloc_stack が必要
  • alloc_stack と対応する dealloc_stack をセットで見ると、その値・一時領域がどこからどこまで生きているかを追いやすい。

  • store_weak

  • weak参照を保存する命令。
  • 対象オブジェクトが解放されれば、そのweak参照は nil になり得る -[initialization] の有無は少し重要
store_weak ... [init]   ← weak参照を最初に作る
store_weak ...          ← 既存のweak参照を書き換える

→ ライフサイクルが変わっていそう

apple-swift.readthedocs.io

@@ -254,21 +254,21 @@

キーワード - begin_access, [dynamic], [static], load_weak, @closureCapture

  • begin_access
  • begin_access は、あるメモリ領域へのアクセス開始を表す命令。
  • begin_access でメモリへのアクセスが始まる
  • 対応する end_access でアクセスが終わる
  • [read] は読み取り
  • [modify] は変更
  • [init] は未初期化領域の初期化
  • [deinit] は初期化済み領域を未初期化状態にする
  • [static] / [dynamic] などは、排他アクセスをどう保証するかを示す

github.com

【@@ -60,22 +60,22 @@】

26.2と26.6で、weak self の参照・解放のタイミングが逆になっていることがわかった

26.2:

L69: メモリを確保
    %7 = alloc_stack [lexical] [var_decl] $@sil_weak Optional<Owner> // users: %13, %15, %14, %10  

L72: 弱参照で %7を格納
  store_weak %9 to [init] %7                      // id: %10

L76: アドレス %7 をclosureへ渡す
    %13 = apply %12(%7, %2) : $@convention(thin) (@inout_aliasable @sil_weak Optional<Owner>, @inout_aliasable Counter) -> ()

L77: メモリ内の値を破棄
  destroy_addr %7                                 // id: %14

L78: メモリの破棄  dealloc_stack %7                                // id: %15

26.6:

L69: メモリを確保
  %7 = alloc_stack [lexical] $@sil_weak Optional<Owner> // users: %15, %10, %14, %13
  strong_retain %0    

L72: 弱参照で %7を格納
  store_weak %9 to [init] %7                      // id: %10

L76: メモリ内の値を破棄
  destroy_addr %7                                 // id: %13

L77: メモリの破棄
  dealloc_stack %7                                // id: %14

L78: アドレス %7 をclosureへ渡す
  %15 = apply %12(%7, %2) : $@convention(thin) (@inout_aliasable @sil_weak Optional<Owner>, @inout_aliasable Counter) -> ()

closure呼び出し時点では %7 のstorage lifetimeが終了している

@@ -254,21 +254,21 @@

bb0(%0 : @closureCapture $*@sil_weak Optional<Owner>, %1 : @closureCapture $*Counter):
L78: ` function_ref @$s4main5OwnerC4testyyFyycfU_Tf0ss_n `を呼び出し
  %15 = apply %12(%7, %2) : $@convention(thin) (@inout_aliasable @sil_weak Optional<Owner>, @inout_aliasable Counter) -> ()
    %12 は下記
      %12 = function_ref @$s4main5OwnerC4testyyFyycfU_Tf0ss_n : $@convention(thin) (@inout_aliasable @sil_weak Optional<Owner>, @inout_aliasable Counter) -> () // user: %15


L256: 呼び出し側
// specialized closure #1 in Owner.test()
sil private @$s4main5OwnerC4testyyFyycfU_Tf0ss_n : $@convention(thin) (@inout_aliasable @sil_weak Optional<Owner>, @inout_aliasable Counter) -> () {


L259:
bb0(%0 : @closureCapture $*@sil_weak Optional<Owner>, %1 : @closureCapture $*Counter):

%13 = apply %12(%7, %2) : $@convention(thin) (@inout_aliasable @sil_weak Optional, @inout_aliasable Counter) -> () の順番しか差がなくって謎すぎる

結論

SILを見ると確かにclosure呼び出しとweak storageのlifetime endのタイミングがずれていることが確認できた。 意外とSILって読めるんだな。。。